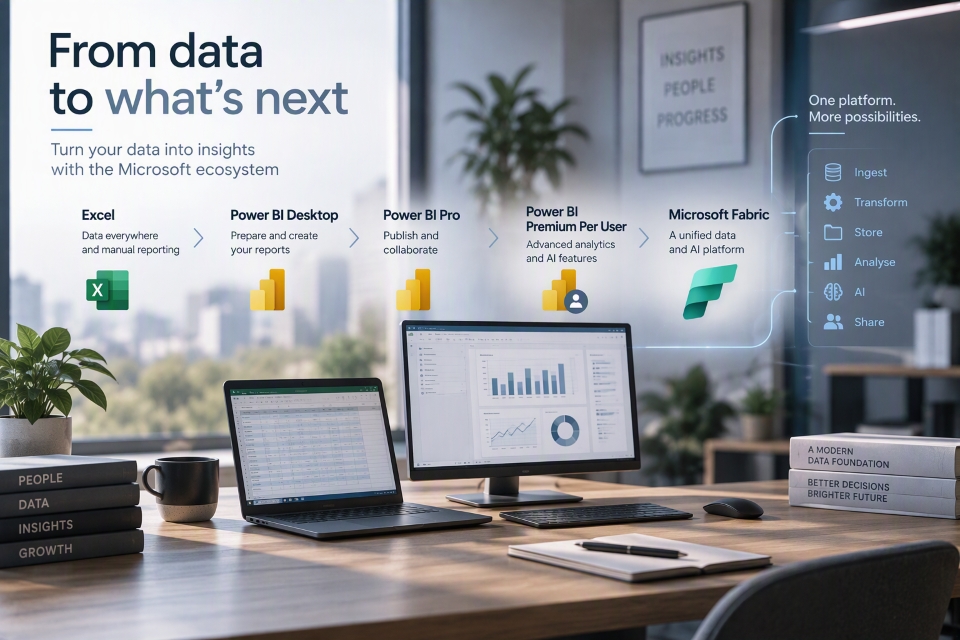
De nombreux projets décisionnels commencent avec des fichiers Excel, plusieurs applications métier et des rapports préparés manuellement. Chaque mois, les équipes extraient les mêmes données, les copient dans différents fichiers et reconstruisent leurs indicateurs.
Cette méthode peut fonctionner au début. Mais lorsque les sources et les utilisateurs se multiplient, ses limites apparaissent : plusieurs versions d’un même chiffre, des formules difficiles à maintenir et beaucoup de temps consacré à la préparation plutôt qu’à l’analyse.
La Business Intelligence, ou BI, permet de connecter les sources, préparer les données selon des règles communes et présenter des indicateurs fiables dans des rapports interactifs.
À quoi sert la Business Intelligence ?
Prenons une direction commerciale dont les données sont réparties entre un CRM, un logiciel de gestion et plusieurs fichiers Excel.
Sans outil de BI, une personne doit rapprocher manuellement les ventes, les objectifs et les marges. Avec Power BI, l’entreprise peut connecter ces sources, appliquer les mêmes règles de transformation et construire un modèle partagé.
Les utilisateurs peuvent alors analyser les résultats par période, agence, produit ou territoire. Excel reste utile pour la saisie et les analyses ponctuelles. Power BI devient pertinent lorsque l’entreprise souhaite fiabiliser, réutiliser et diffuser ses indicateurs.
Étape 1 : Power BI Desktop pour créer ses rapports
Power BI Desktop est une application gratuite permettant de connecter des sources, préparer les données avec Power Query, construire un modèle sémantique, créer des mesures DAX et concevoir des rapports interactifs.
Cette étape convient à une personne qui travaille seule ou souhaite tester un cas d’usage. Le fichier peut être transmis manuellement, mais cette méthode n’apporte ni diffusion centralisée, ni collaboration en ligne, ni gestion structurée des accès.
Microsoft présente l’outil dans sa documentation Power BI Desktop (s’ouvre dans un nouvel onglet).
Étape 2 : Power BI Pro pour publier et collaborer
Power BI Pro est la licence standard pour la BI collaborative. Elle permet de publier des rapports dans des espaces de travail, de partager du contenu et de collaborer.
Dans un environnement Power BI Pro standard, les auteurs et les lecteurs du contenu partagé doivent disposer d’une licence Power BI Pro ou d’une licence compatible.
Cette formule peut suffire durablement lorsque les données sont déjà organisées et que le besoin concerne principalement le reporting. Microsoft détaille les droits associés aux licences dans la documentation sur les fonctionnalités Power BI par type de licence (s’ouvre dans un nouvel onglet).
Étape 3 : Premium Per User pour des usages avancés
Power BI Premium Per User, ou PPU, reprend les fonctionnalités de Pro et ajoute la plupart des fonctionnalités Power BI Premium sur une base individuelle.
PPU peut convenir à une population ciblée travaillant sur des modèles plus exigeants. Sa principale contrainte concerne la diffusion : les utilisateurs qui consultent le contenu d’un espace de travail PPU doivent normalement disposer d’une licence PPU appropriée.
PPU reste une licence Power BI individuelle. Elle ne provisionne pas une capacité Microsoft Fabric permettant, à elle seule, d’exécuter des Lakehouses, des Warehouses ou des notebooks. Cette distinction est expliquée dans la documentation sur les licences et capacités Fabric (s’ouvre dans un nouvel onglet).
L’analyse intelligente dans Power BI
Power BI peut repérer des valeurs inhabituelles, des variations significatives, des tendances ou des corrélations. Ces fonctions aident l’utilisateur à orienter son analyse, mais ne remplacent pas la connaissance métier.
Microsoft décrit ces possibilités dans la documentation sur les insights Power BI (s’ouvre dans un nouvel onglet).
Copilot dans Power BI
Copilot permet de formuler certaines demandes en langage naturel. Selon l’expérience disponible, il peut aider à explorer ou résumer un rapport, expliquer des résultats et générer ou expliquer des expressions DAX.
La qualité des réponses dépend de la préparation du modèle sémantique. Les mesures, relations et définitions métier doivent être explicites.
Une licence PPU ne suffit pas, à elle seule, pour activer Copilot. Microsoft demande notamment une capacité payante éligible, une région prise en charge et l’activation des paramètres administratifs correspondants. Ces conditions sont détaillées dans la présentation de Copilot pour Power BI (s’ouvre dans un nouvel onglet).
Étape 4 : Microsoft Fabric pour industrialiser les données
Lorsque les sources, les volumes et les usages se multiplient, le besoin ne se limite plus à créer des rapports. L’entreprise doit aussi organiser la manière dont les données sont collectées, préparées, stockées et mises à la disposition des équipes.
Microsoft Fabric réunit ces différentes étapes dans une même plateforme. L’objectif est de construire une chaîne de données cohérente : les informations sont récupérées depuis les applications de l’entreprise, contrôlées et transformées, puis organisées pour alimenter les analyses et les rapports Power BI.
Fabric peut notamment prendre en charge :
- des pipelines d’ingestion et de transformation, qui automatisent la récupération des données depuis des fichiers, des applications ou des bases de données, puis leur préparation pour les usages analytiques ;
- des Lakehouses, qui réunissent des fichiers et des tables dans un même environnement afin de conserver différents types de données et de les exploiter avec plusieurs outils d’analyse ;
- des Warehouses, qui organisent les données structurées dans un entrepôt adapté aux requêtes SQL, au reporting et au suivi des indicateurs ;
- des notebooks, qui permettent aux équipes data d’écrire, de documenter et d’exécuter du code, ainsi que des traitements Apache Spark conçus pour transformer des volumes importants de données ;
- l’analyse de données et d’événements en temps réel, utile lorsqu’une information doit être exploitée dès son arrivée, par exemple pour suivre une activité opérationnelle, des événements applicatifs ou des données provenant de systèmes connectés ;
- des modèles sémantiques, qui traduisent les données techniques en notions compréhensibles par les métiers, avec des relations, des indicateurs et des règles de calcul partagés ;
- des rapports Power BI, qui présentent les résultats sous forme de visualisations interactives accessibles aux utilisateurs autorisés.
Ces composants ne sont pas des outils isolés. Ils correspondent aux différentes étapes d’un même parcours : collecter les données, les transformer, les organiser, définir des indicateurs communs, puis les restituer aux utilisateurs.
Ces expériences s’appuient sur OneLake, la fondation de stockage unifiée de Microsoft Fabric. OneLake fournit un emplacement logique commun aux différents composants de la plateforme, afin que plusieurs usages analytiques puissent travailler sur les mêmes données sans multiplier inutilement les copies.
Microsoft distingue notamment le Warehouse, principalement orienté vers les données structurées, les requêtes SQL et le reporting, et le Lakehouse, qui associe le stockage de fichiers, les tables Delta et les traitements avec Spark ou SQL.
Pour une entreprise habituée à Excel, l’intérêt est concret. Les données du CRM, de l’ERP, des fichiers et des autres applications peuvent être collectées et préparées selon des règles communes, puis réutilisées dans plusieurs modèles sémantiques, rapports Power BI et projets analytiques.
L’entreprise ne remplace donc pas simplement un fichier Excel par un nouvel outil. Elle met progressivement en place une chaîne de données partagée, plus facile à maintenir, à sécuriser et à faire évoluer.
Microsoft présente les principaux composants de la plateforme dans les documentations Qu’est-ce que Microsoft Fabric ? (s’ouvre dans un nouvel onglet) et Qu’est-ce que OneLake ? (s’ouvre dans un nouvel onglet).
Exemple concret : le parcours des données commerciales dans Fabric
Prenons l’exemple d’une entreprise qui suit ses ventes à partir de trois sources : son CRM, son ERP et des fichiers Excel transmis par les équipes régionales.
Un pipeline d’ingestion et de transformation récupère régulièrement les données de ces différentes sources. Il automatise des opérations auparavant réalisées manuellement, comme l’importation des fichiers, l’harmonisation des formats et la préparation des informations nécessaires à l’analyse.
Les données peuvent d’abord être déposées dans un Lakehouse. Celui-ci permet de conserver les informations provenant des différents systèmes, y compris les fichiers d’origine et les tables préparées.
Des notebooks et des traitements Apache Spark peuvent ensuite appliquer des transformations plus avancées. L’entreprise peut, par exemple, harmoniser les références produits, corriger certains formats ou rapprocher les clients présents dans plusieurs applications.
Une fois nettoyées et organisées, les données utiles au reporting peuvent alimenter un Warehouse. L’entreprise y structure les ventes, les produits, les clients, les territoires et les objectifs sous une forme adaptée aux analyses SQL.
Un modèle sémantique Power BI est ensuite construit sur ces données. Il définit les relations entre les informations et les indicateurs métier partagés, comme le chiffre d’affaires, la marge, le taux de réalisation des objectifs ou l’évolution des ventes.
Les utilisateurs consultent enfin ces indicateurs dans des rapports Power BI interactifs. Les responsables peuvent filtrer les résultats par période, produit, agence ou territoire sans recréer un fichier différent pour chaque analyse.
Si l’entreprise reçoit également des données qui doivent être suivies dès leur arrivée, Fabric peut compléter ce parcours avec l’analyse en temps réel. Il devient alors possible de rapprocher les indicateurs historiques des événements opérationnels récents.
Tout au long de ce parcours, OneLake fournit la fondation de stockage commune. Les composants de Fabric interviennent à des étapes différentes, mais travaillent dans un environnement partagé : le pipeline collecte les données, le Lakehouse les conserve et facilite leur transformation, le Warehouse les organise, le modèle sémantique leur donne un sens métier et Power BI les restitue aux utilisateurs.
L’entreprise passe ainsi d’un reporting reconstruit manuellement dans plusieurs fichiers Excel à une chaîne de données partagée, reproductible et plus simple à faire évoluer.
Ce que l’IA ajoute à Microsoft Fabric
L’intelligence artificielle dans Fabric ne se limite pas à l’interrogation d’un rapport. Elle peut intervenir à plusieurs étapes du parcours des données.
Copilot peut assister certaines tâches de préparation, de développement et d’analyse. Il peut notamment aider les équipes à travailler sur des transformations, des requêtes, des pipelines ou du code. Les résultats proposés doivent néanmoins être vérifiés avant leur utilisation dans un environnement de productionpeut, par exemple, produire une prévision de la demande ou un score de renouvellement, puis restituer le résultat dans Power BI.
Une prédiction n’est jamais une certitude. Sa qualité dépend des données utilisées, de la méthode retenue, de sa validation et de son suivi dans le temps.
Les prérequis d’utilisation sont présentés dans la documentation Microsoft sur l’activation et la configuration de Copilot dans Microsoft Fabric (s’ouvre dans un nouvel onglet).
Quel parcours choisir ?
- Power BI Desktop pour créer ses premiers rapports ;
- Power BI Pro pour publier, partager et collaborer ;
- Power BI Premium Per User pour des fonctionnalités avancées ;
- Microsoft Fabric pour construire une plateforme de données et développer des usages d’IA.
Une organisation peut rester sur Power BI Pro si cette solution couvre ses besoins. Elle peut aussi passer directement à Fabric si son projet nécessite un entrepôt de données, des pipelines ou une plateforme analytique commune.
MC3 Cloud propose un service de service:power-bi-business-reporting couvrant la définition des indicateurs, la préparation des données, la création de rapports, l’actualisation, le partage sécurisé, la formation et la maintenance.